⏱ زمان مطالعه: 10 دقیقه
انتخاب نادرست روش تحلیل آماری میتواند اعتبار ماهها تلاش پژوهشی را زیر سوال ببرد و به نتایج آماری گمراهکننده منجر شود. بسیاری از پژوهشگران و دانشجویان تحصیلات تکمیلی پس از گردآوری دادهها، در مرحله تحلیل فصل چهارم پایاننامه یا مقالات علمی، با این پرسش مواجه میشوند که بر چه اساسی باید ابزار پردازش فرضیهها را برگزینند. نحوه انتخاب آزمون آماری مناسب تابع یک روند منطقی، قانونمند و مبتنی بر ساختار طراحی تحقیق است که شناخت دقیق معیارهای آن، فرآیند پژوهش را به مسیری قابل اعتماد هدایت میکند.
شناسایی هدف پژوهش و ماهیت فرضیهها
نقطه آغاز تصمیمگیری برای انتخاب شیوه آزمون، درک شفاف سوال پژوهش است. تحلیلگر پیش از رجوع به هر بسته نرمافزاری، باید نوع گزاره فرضیه خود را مشخص کند؛ چرا که ابزارهای تحلیلی در آمار استنباطی اساساً برای پاسخ به سه پرسش متمایز ساخته شدهاند: مقایسه تفاوت میان گروهها، سنجش همبستگی یا پیوند میان متغیرها، و پیشبینی یا مدلسازی تغییرات یک متغیر بر اساس متغیرهای دیگر.
زمانی که هدف اصلی تحقیق بررسی اختلاف در یک شاخص خاص باشد، روشهای مقایسهای کاربرد دارند. به عنوان نمونه، پژوهشگری فرضیهای فرضی را مطرح میکند مبنی بر اینکه میانگین رضایت شغلی کارکنان دورکار با کارکنان حضوری متفاوت است. در این سناریو، مسئله کشف رابطه علت و معلولی چندعاملی نیست، بلکه تنها تفاوت میانگین دو گروه سنجیده میشود. در مقابل، اگر فرضیه درباره بررسی شدت و جهت پیوند میان ساعات مطالعه هفتگی و معدل تحصیلی باشد، نیاز به ابزارهای تحلیل همبستگی یا پیوند خواهد بود. همچنین در فرضیههای تبیینی که اثر چند متغیر پیشبین بر یک متغیر ملاک آزموده میشود، روشهای خانواده رگرسیون باید مدنظر قرار گیرند.
اشتباه متداول در این گام، عدم تفکیک میان فرضیههای مقایسهای و همبستگی است. مواردی دیده میشود که پژوهشگر برای فرضیهای با ماهیت مقایسه، ضریب همبستگی محاسبه میکند یا برعکس. یک بررسی مقدماتی ساده برای رفع این خطا، بازنویسی صریح گزاره است: اگر ساختار جمله بر پایه «وجود تفاوت معنادار میان گروهها» شکل گرفته باشد، آزمون مقایسهای است و چنانچه ساختار بر مبنای «میزان همراهی تغییرات دو متغیر» یا «پیشبینی مقادیر» باشد، باید سراغ روشهای همبستگی و رگرسیونی رفت.
نقش مقیاس سنجش متغیرها در انتخاب آزمون
سطح سنجش متغیرهای پژوهش مهمترین معیار فنی در تعیین مسیر تحلیل است. دادهها بر اساس دقت ریاضی خود در چهار مقیاس اسمی، ترتیبی، فاصلهای و نسبی طبقهبندی میشوند. این سطوح، دایره عملیات ریاضی مجاز روی دادهها را تعیین کرده و مستقیماً آزمون مجاز را مشخص میکنند.
متغیرهای اسمی صرفاً هویت یا طبقهبندی را نشان میدهند (مانند جنسیت، رشته تحصیلی یا شهر محل سکونت) و محاسبه میانگین برای آنها فاقد معنای ریاضی است. متغیرهای ترتیبی علاوه بر دستهبندی، رتبهبندی کیفی را هم منتقل میکنند (مانند گویههای پنجدرجهای لیکرت به عنوان یک سنجه منفرد، سطح تحصیلات یا رتبههای نظامی). در متغیرهای فاصلهای و نسبی، فواصل میان اعداد برابر است و امکان محاسبات کامل عددی از جمله میانگین و واریانس وجود دارد (مانند سن به سال، نمره آزمون استاندارد، درآمد ریالی و زمان واکنش بر حسب ثانیه).
راهنمای جامع این موضوع: تحلیل آماری پایاننامه و پژوهش
برای بررسی تفاوت، اگر متغیر وابسته از نوع اسمی باشد، باید از روشهای ناپارامتریک مانند خیدو استفاده کرد؛ اما اگر متغیر وابسته فاصلهای یا نسبی باشد، تحلیلهایی مانند آزمونهای تی یا تحلیل واریانس مطرح میشوند. فرض کنید در یک مطالعه مقایسهای فرضی، بازده سرمایهگذاری (متغیر فاصلهای) میان سه صنعت مختلف بررسی میشود؛ در این حالت متغیر وابسته کمی است. اما اگر بازده تنها با برچسبهای «موفق / ناموفق» (متغیر اسمی دوحالته) سنجیده میشد، استفاده از ابزارهای تحلیلی میانگینمحور به کلی نامعتبر بود. اشتباه رایج در مقالات، تلقی کردن متغیرهای اسمی کدگذاریشده به عنوان متغیر کمی است؛ کدگذاری عدد ۱ برای مرد و ۲ برای زن نباید تحلیلگر را به محاسبه میانگین برای متغیر جنسیت سوق دهد.
شرایط توزیع دادهها و بررسی پیشفرضهای آماری
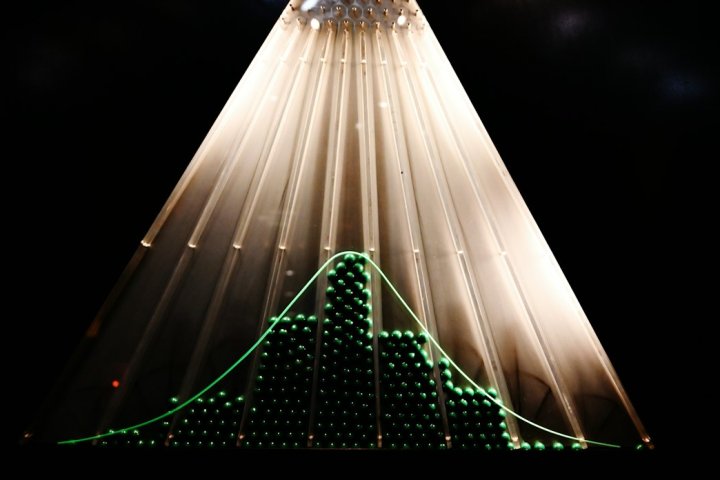
پس از بررسی نوع متغیر، اعتبارسنجی پیشفرضهای توزیع، مرز میان روشهای پارامتریک و ناپارامتریک را ترسیم میکند. روشهای پارامتریک از اعتبار و توان آماری بالاتری برخوردارند اما بهکارگیری آنها مشروط به برقرار بودن مفروضاتی نظیر توزیع نرمال متغیر وابسته و برابری واریانسها است. در صورتی که این شروط نقض شوند، نتایج آزمونهای پارامتریک دچار تورش و خطای تصمیمگیری میگردد.
توزیع نرمال معمولاً با شاخصهای کجی و کشیدگی، نمودارهای هیستوگرام یا برازش آماری شاپیرو-ویلک و کولموگروف-اسمیرنوف ارزیابی میشود. چنانچه دادههای وابسته از توزیع نرمال فاصله فاحشی داشته باشند یا حجم نمونه به اندازهای اندک باشد که فرض نرمال بودن تایید نشود، باید به همتای ناپارامتریک آن روش مهاجرت کرد. روشهای ناپارامتریک متکی بر رتبهبندی دادهها هستند و به شکل توزیع جامعه حساسیت نشان نمیدهند.
به عنوان یک مثال فرضی، فرض کنید نمرات پرخاشگری در جامعهای با ۳۵ نفر اندازه گرفته شده و شاخص شاپیرو-ویلک حاکی از انحراف شدید از توزیع زنگولهای نرمال است. در این موقعیت، جایگزینی آزمون پارامتریک با نسخه ناپارامتریک ضرورت علمی دارد. خطای پرتکرار، اکتفای صرف به مقدار معناداری شاپیرو-ویلک در نمونههای بسیار بزرگ یا بسیار کوچک است. در نمونههای بسیار بزرگ، حتی انحرافات بسیار جزیی هم ممکن است در این آزمونها معنادار شوند؛ بنابراین بررسی نمودار Q-Q و مقادیر کجی بین بازه منفی ۱ تا مثبت ۱ راهکار مناسبی برای اطمینان از سلامت مفروضه قبل از انتخاب نهایی آزمون است.
تعداد گروهها و ساختار طراحی مطالعه
معیار سرنوشتساز دیگر در طبقهبندی آزمونهای مقایسهای، تعداد گروههای مستقل یا تعداد دفعات اندازهگیری متغیر است. طراحیهای پژوهشی به دو دسته بنیادین نمونههای مستقل (بینآزمودنیها) و نمونههای وابسته یا جفتشده (درونآزمودنیها) تقسیم میشوند. این تمایز ساختاری، فرمول ریاضی محاسبه واریانس خطا را دستخوش تغییر اساسی میکند.
اگر قصد مقایسه دو گروه کاملاً مجزا از یکدیگر را داشته باشید (برای مثال، گروه کنترل و گروه آزمایش)، ماهیت نمونهها مستقل است. در صورتی که دادهها نرمال باشند از آزمون تی دو گروه مستقل و در غیاب نرمال بودن از آزمون یومن ویتنی استفاده میشود. اما چنانچه همان افراد در دو مقطع زمانی پیش از آموزش و پس از آموزش ارزیابی شوند، نمونهها وابسته خواهند بود؛ در این وضعیت آزمون تی زوجی یا نسخه ناپارامتریک آن یعنی آزمون ویلکاکسون باید انتخاب شود.
مطلب مرتبط: انتخاب موضوع پایاننامه و ایدههای پژوهشی
چنانچه تعداد گروهها از دو سطح فراتر رود (برای نمونه، مقایسه چهار روش درمانی مختلف)، دیگر نمیتوان از آزمونهای مقایسه دو میانگین استفاده کرد. اجرای پیدرپی چندین آزمون تی دوگروهی، خطای نوع اول (مثبت کاذب) را بهشدت افزایش میدهد. در چنین شرایطی، برای دادههای نرمال مستقل از تحلیل واریانس یکطرفه و در حالت غیرنرمال از آزمون کروسکال والیس بهره گرفته میشود. اگر همین طراحی شامل اندازهگیری مکرر سه بار در طول زمان باشد، روش تحلیل واریانس با اندازهگیریهای مکرر یا آزمون فریدمن جایگزین مناسب خواهند بود.
ماتریس کاربردی انتخاب آزمونهای آماری
برای ایجاد ساختار شفاف و جلوگیری از سردرگمی در انتخاب روش مناسب، تجمیع شروط تصمیمگیری در یک ساختار مقایسهای، بهترین راهنمای پژوهشگر است. تصمیمگیری نهایی همواره حاصل ترکیب نوع فرضیه، مقیاس سنجش و برقراری یا عدم برقراری پیشفرض نرمال بودن است.
| هدف فرضیه | نوع و مقیاس متغیرها | آزمون پارامتریک (توزیع نرمال) | آزمون ناپارامتریک (عدم توزیع نرمال یا مقیاس رتبهای) |
|---|---|---|---|
| مقایسه یک گروه با مقدار ثابت | یک متغیر کمی فاصلهای/نسبی | آزمون تی تکنمونهای | آزمون علامت یا ویلکاکسون تکنمونهای |
| مقایسه دو گروه مستقل | مستقل: اسمی دوسطحی / وابسته: کمی | آزمون تی دو نمونه مستقل | آزمون یومن ویتنی |
| مقایسه دو گروه وابسته (زوجی) | مستقل: دو موقعیت سنجش / وابسته: کمی | آزمون تی وابسته (زوجی) | آزمون ویلکاکسون رتبهدار |
| مقایسه سه گروه یا بیشتر (مستقل) | مستقل: اسمی چندسطحی / وابسته: کمی | تحلیل واریانس یکراهه (ANOVA) | آزمون کروسکال والیس |
| مقایسه سه موقعیت یا بیشتر (وابسته) | مستقل: زمان یا دفعات / وابسته: کمی | تحلیل واریانس اندازهگیری مکرر | آزمون فریدمن |
| بررسی رابطه میان دو متغیر | دو متغیر پیوسته (فاصلهای یا نسبی) | ضریب همبستگی پیرسون | ضریب همبستگی رتبهای اسپیرمن |
| بررسی استقلال یا تداعی | دو متغیر کیفی (اسمی یا ترتیبی) | ـ | آزمون خیدو استقلال یا دقیق فیشر |
| پیشبینی متغیر پیوسته | پیشبین: کمی یا دستهای / ملاک: کمی | رگرسیون خطی (ساده یا چندگانه) | رگرسیون ناپارامتریک / مقاوم |
| پیشبینی متغیر دوسطحی | پیشبین: کمی یا کیفی / ملاک: اسمی دوگانه | ـ | رگرسیون لجستیک دوحالتی |
جدول بالا مانند یک قطبنمای هدایتگر، وابستگی زنجیروار روشها را به ساختار دادهها نشان میدهد. برای اجرای درست، کافی است ردیف مربوط به طراحی مطالعه انتخاب شده و بر اساس ارزیابیهای اولیه نرمال بودن، ستون مربوطه مبنای آزمون قرار گیرد.
گامهای مرحلهبهمرحله تعیین آزمون آماری مناسب
به منظور جلوگیری از آشفتگی تحلیلی، طی کردن گامهای نظاممند زیر تضمینکننده گزینش صحیحترین ابزار آماری برای هر مجموعه داده پژوهشی است:
- تعیین دقیق نقش متغیرها در مدل مفهومی به عنوان متغیر مستقل، وابسته، تعدیلگر، میانجی یا کنترل.
- مشخص کردن مقیاس دقیق سنجش هر متغیر در مرحله اندازهگیری (اسمی، ترتیبی، فاصلهای یا نسبی).
- تدوین عبارت ریاضی فرضیه بر اساس هدف تحلیل (تفاوت، رابطه، پیشبینی یا ساختار عاملی).
- سنجش ساختار گروهها از حیث وابستگی، همتا بودن یا استقلال از یکدیگر در آزمونهای مقایسهای.
- اجرای تحلیلهای اکتشافی دادهها برای بررسی توزیع نرمال، تقارن و شناسایی دادههای پرت.
- بررسی یکدستی واریانسها در صورت ورود به گروه آزمونهای مقایسهای پارامتریک از طریق آزمون لون.
- انتخاب نام آزمون منطبق با وضعیت پیشفرضها و پیادهسازی محاسبات در ابزار پردازش آماری.
نادیده گرفتن هر یک از گامهای فوق، اثر دومینووار روی کل تحلیل دارد. برای مثال، نادیده گرفتن مرحله شناسایی دادههای پرت میتواند واریانس را به صورت تصنعی افزایش داده و مانع تایید معناداری تفاوتی شود که در واقعیت پژوهش وجود دارد.
مطلب مرتبط: ابزارهای هوش مصنوعی برای تدوین پروپوزال
خطاهای متداول پژوهشگران در فرایند گزینش روشهای آماری
یکی از آسیبهای جدی در مقالات دانشگاهی، غفلت از بررسی خطای نوع اول ناشی از آزمونهای مکرر است. پژوهشگرانی که چهار متغیر وابسته مختلف را برای دو گروه مقایسه میکنند، گاهی به جای استفاده از تحلیل واریانس چندمتغیره (مانوا)، چهار بار پیاپی آزمون تی مستقل انجام میدهند. این کار احتمال پذیرش نادرست فرضیه و خطای استنتاجی را بهشدت افزایش میدهد.
اشتباه رایج دیگر، سردرگمی در مقیاس ترکیبی پرسشنامههاست. گویههای لیکرت در ذات خود مقیاس رتبهای هستند، اما زمانی که چندین گویه همراستا برای ساختن نمره کل یک سازه جمعبندی یا میانگینگیری میشوند، امتیاز کلی حاصل در ادبیات تجربی به صورت فاصله تلقی میشود. در صورت تایید پایایی و سلامت سازه، میتوان آن متغیر ترکیبی را تحت آزمونهای پارامتریک درآورد؛ در حالی که تحلیل تکتک سوالات به طور منفرد تنها مستلزم روشهای ناپارامتریک است.
همچنین نادیده گرفتن متغیرهای کنترل در فرضیههای همبستگی سبب انتشار نتایج کاذب میشود. در شرایطی که متغیر سومی بر رفتار دو متغیر دیگر اثر همزمان دارد، انتخاب همبستگی ساده به جای همبستگی تفکیکی یا جزئی، تفسیری وارونه از دادهها تولید خواهد کرد. پیش از نهاییسازی آزمون، رسم ماتریس پراکندگی و چک کردن همخطی متغیرها سلامت استنتاج علمی را تقویت میکند.
پرسشهای متداول
اگر توزیع دادهها نرمال نباشد ولی حجم نمونه بالا باشد میتوان از آزمون پارامتریک استفاده کرد؟
مطابق با قضیه حد مرکزی، در صورتی که حجم نمونه به اندازه کافی بزرگ باشد (معمولاً بالای ۳۰ تا ۵۰ مورد در هر گروه) و دادهها فاقد نقاط پرت بحرانی باشند، توزیع میانگینهای نمونهگیری میل به نرمال پیدا میکند؛ با این حال در صورت انحراف شدید چولگی و کشیدگی، ترجیح روششناختی همچنان بهرهگیری از آزمونهای ناپارامتریک یا روشهای بوتاسترپینگ است.
تفاوت اصلی رگرسیون با آزمون همبستگی در انتخاب ابزار چیست؟
همبستگی تنها به ارزیابی درجه و جهت همراهی خطی دو متغیر بدون در نظر گرفتن رابطه علیت یا تمایز متغیر وابسته و مستقل میپردازد؛ اما رگرسیون بر پایه معادله ریاضی پیشبینی تنظیم شده و توان تبیین سهم تغییرات متغیر وابسته را به ازای تغییر در متغیرهای پیشبین داراست.
چرا نمیتوان برای مقایسه سه گروه از چند آزمون تی مستقل متوالی استفاده کرد؟
با انجام مکرر آزمون تی برای مقایسههای جفتی (مثلا مقایسه گروه اول با دوم، دوم با سوم، و اول با سوم)، سطح خطای کلی آزمایش متورم میشود و شانس رسیدن به یک نتیجه مثبت کاذب افزایش چشمگیری مییابد. روش درست، اجرای اولیه تحلیل واریانس و سپس ورود به آزمونهای تعقیبی است.
ادامهی مطالعه: